Einheitlich steuerbares Monitoring als Grundlage für AI-gestützte Operations.
Herausforderung
Zuverlässiges Monitoring wird zur Herausforderung, wenn Veränderung der Normalzustand ist.
Mit jeder Technologiegeneration ist der Weg von der Idee zum laufenden System kürzer geworden. Automatisierte Serverbereitstellung, die Cloud mit flexibel skalierbaren Ressourcen und dauerhaft integrierten SaaS-Diensten und zuletzt AI-gestützte Entwicklung lassen Anwendungen immer schneller entstehen und sich verändern.
Für den Betrieb heißt das: Die Zahl der Anwendungen, Dienste und überwachten Objekte wächst, Veränderungen werden häufiger und Abhängigkeiten dichter. Monitoring- und Observability-Konfigurationen müssen laufend aktualisiert werden, während historisch gewachsene Alarmierungsstrukturen immer komplexer werden. Die Folge sind Fehlalarme, hoher Betriebsaufwand und fehlende Transparenz über Überwachung, Weiterleitung und Verantwortung. Den vollständigen Zusammenhang können einzelne Teams kaum noch überblicken.
Das zeigt sich auch im Markt: Unternehmen nutzen mehrere Monitoring- und Observability-Technologien parallel, während Komplexität, fehlender Kontext und der Aufwand für die Alert-Bearbeitung zu den zentralen Belastungen im Betrieb zählen. Entscheidend ist deshalb nicht allein, mehr Daten zu erfassen. Es kommt darauf an, relevante Ereignisse systemübergreifend einzuordnen, Zuständigkeiten zu bestimmen und den passenden Bearbeitungsweg auszulösen.
Adaptive Monitoring setzt hier mit einem durchgängigen Betriebsframework für Monitoring und Observability an. Wiederverwendbare Monitoring-Pakete, automatisierte Bereitstellung und kontrollierter Self-Service reduzieren manuelle Einzellösungen, schaffen klare Verantwortlichkeiten und bilden die Grundlage für AI-gestützte Operations.
Relevanz
Warum das jetzt relevant ist
Adaptive Monitoring ist besonders relevant, wenn
hybride IT-Landschaften über Cloud- und On-Premises-Umgebungen hinweg konsistent überwacht werden müssen,
historisch gewachsene Monitoring-Konfigurationen und Betriebsprozesse vereinfacht, wiederverwendbar gemacht und automatisiert werden sollen,
Alarmfluten, Betriebsdaten aus unterschiedlichen Systemen und unklare Verantwortlichkeiten die Bearbeitung kritischer Ereignisse erschweren,
bestehende Monitoring- und Observability-Systeme in ein einheitliches Betriebsmodell integriert und kontrolliert im Self-Service nutzbar werden sollen,
Operations-Prozesse schrittweise um AI-gestützte Analyse, Korrelation und spezialisierte Agenten erweitert werden sollen und dafür eine kontrollierbare operative Grundlage gebraucht wird.
Ansatz
System & Struktur des Ansatzes
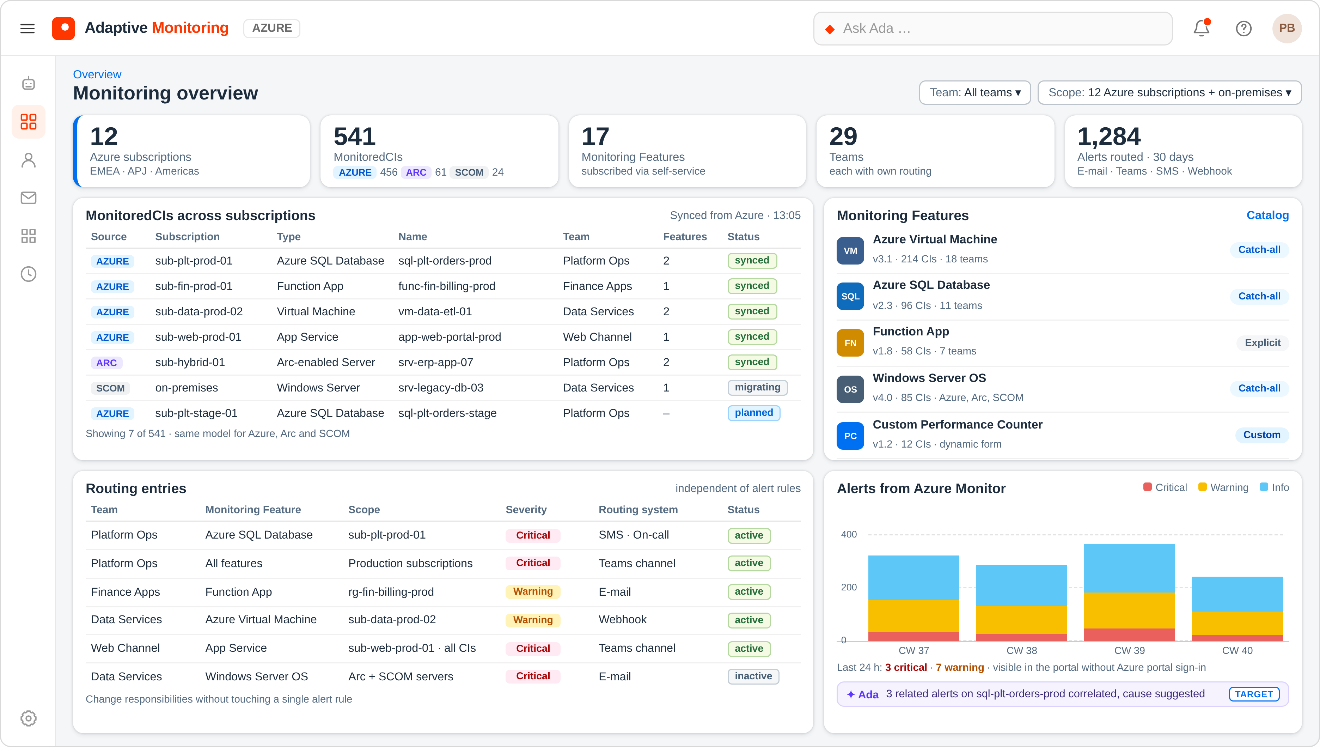
Adaptive Monitoring macht bewährte Monitoring-Konfigurationen wiederverwendbar und stellt sie automatisiert für unterschiedliche Anwendungen und Umgebungen bereit. Wiederkehrende Anforderungen müssen so nicht für jeden Anwendungsfall neu umgesetzt werden. Monitoring-Pakete lassen sich innerhalb definierter Leitplanken an den jeweiligen operativen Kontext anpassen.
IT-Service-Verantwortliche und technische Teams, etwa aus Anwendungsbetrieb, Infrastruktur, Cloud und DevOps, steuern Monitoring, Alarmierungswege und Wartungsfenster, ohne die Besonderheiten einzelner Monitoring-Systeme kennen zu müssen. Adaptive Monitoring ist damit kein einzelnes Monitoring-Tool, sondern ein architekturgetriebenes Betriebsframework auf einer cloud-nativen Microsoft-Azure-Plattform.
Zentrale Bausteine:
Abonnierbare Monitoring-Pakete Bewährte Überwachungsregeln in transparenten, versionierten Einheiten. Teams abonnieren passende Pakete und passen sie im Self-Service innerhalb definierter Leitplanken an ihre IT-Services an. Je nach Aktivierungsmodell ist die Überwachung automatisch aktiv, gezielt für ausgewählte IT-Objekte aktiviert oder vollständig durch den Anwender konfiguriert.
Trennung von Monitoring und Routing Was überwacht wird, bleibt unabhängig davon steuerbar, wer informiert und welcher Bearbeitungsprozess ausgelöst wird. Ereignisse lassen sich per E-Mail, SMS, über Collaboration-Kanäle und Webhooks sowie an Ticket- und Incident-Management-Systeme oder spezialisierte AI-Agenten weiterleiten.
Automatisierte Bereitstellung Konfiguration, Aktivierung und Wartung laufen weitgehend automatisiert. Deklarative, versionierte Vorgaben werden wiederholbar in die Zielumgebungen ausgerollt. Neue Überwachungsanforderungen und Routing-Ziele sind so schneller umgesetzt.
Kontrollierter Self-Service IT-Service-Verantwortliche verwalten Monitoring-Pakete, Alarmierungswege und Wartungsfenster innerhalb definierter Leitplanken. Spezialwissen über das angebundene Monitoring-System ist dafür nicht erforderlich.
Einheitliche Normalisierung Technische Kennungen aus unterschiedlichen Quellsystemen werden in eine konsistente, verständliche Struktur überführt. Überwachte Objekte bleiben dadurch eindeutig identifizierbar und im Self-Service nutzbar.
Alarmkonsolidierung und Governance Zusammenhängende Ereignisse werden anhand definierter Kriterien gefiltert, korreliert und zu bearbeitbaren Vorgängen gebündelt. Relevante Ereignisse treten so aus dem Alarmrauschen hervor und erhalten den nötigen Kontext. Konfigurationen, Routing-Regeln, Änderungen und Verantwortlichkeiten bleiben dokumentiert und eindeutig zuordenbar.
Zentrales Alert Management Alerts aus unterschiedlichen Umgebungen und angebundenen Monitoring-Systemen laufen in einem zentralen Arbeitsbereich zusammen. Vorgänge lassen sich dort einsehen, bearbeiten und schließen. Statusänderungen werden mit den Quellsystemen synchronisiert.
Dashboarding und Reporting Operative Dashboards und Reports schaffen Transparenz über Alerts, Routings, Bearbeitungsstände und die Verfügbarkeit überwachter IT-Services. Sie unterstützen die Auswertung vereinbarter Serviceziele und SLAs. Für weitergehende Analysen lassen sich spezialisierte Reporting-Werkzeuge anbinden.
Integration Ein API-first-Ansatz stellt Funktionen und Betriebsdaten über standardisierte Schnittstellen bereit. Bestehende Monitoring- und Observability-Systeme und weitere Automatisierungsbausteine lassen sich kontrolliert anbinden, ohne das Betriebsmodell an ein einzelnes Produkt zu binden oder bestehende Werkzeuge vollständig austauschen zu müssen.
Gemeinsam verbinden diese Bausteine technische Signale mit überwachten Objekten, IT-Services, Zuständigkeiten und definierten Bearbeitungswegen zu einem gemeinsamen operativen Kontext.7
AI-gestützte Operations
Die Zielarchitektur erweitert das bewährte Betriebsmodell schrittweise um AI-gestützte Operations, von assistierender Analyse und Korrelation hin zu agentisch orchestrierten Abläufen. Strukturierte Betriebsdaten und definierte Konfigurationen bilden die Grundlage, um AI-gestützte Bewertungen mit verlässlichen Schnittstellen, Regeln und Automationen zu kontrollierten Betriebsabläufen zu verbinden.
Stufe 1: Assistenz und Analyse Ein assistierender Agent unterstützt den Menschen in natürlicher Sprache bei einzelnen Aufgaben. Der Mensch steuert den Ablauf und entscheidet über das weitere Vorgehen:
Alarm- und Betriebsdaten analysieren, Auswertungen und Handlungsempfehlungen erstellen
Monitoring- und Routing-Konfigurationen vorbereiten und prüfen
zusammenhängende Ereignisse korrelieren und mögliche Störungsursachen identifizieren
bei wiederkehrenden Betriebsaufgaben unterstützen
Stufe 2: Agentische Bearbeitung des gesamten Störungsverlaufs Der gesamte Störungsverlauf von der Erkennung bis zur Behebung wird als zusammenhängender Ablauf orchestriert. Spezialisierte Agenten übernehmen klar abgegrenzte Rollen:
Erkennen: Signale aus angebundenen Quellsystemen zusammenführen und auffällige Muster als zusammenhängende Vorgänge erfassen
Orchestrieren: den passenden Bearbeitungsweg bestimmen und den angereicherten Vorgang an ein Team, ein Ticketsystem oder einen Agenten übergeben
Beheben: geprüfte Maßnahmen automatisiert ausführen und verifizieren. Bei Erfolg wird der Vorgang geschlossen, sonst an einen Menschen eskaliert. So werden kontrollierte Self-Healing-Szenarien möglich.
Verbessern: Verlauf, Entscheidungen und Wirkungen dokumentieren und für künftige Vorgänge nutzbar machen
Voraussetzung sind klar definierte Konfigurationen, zugeordnete Zuständigkeiten und nachvollziehbare Entscheidungen.
Governance by Design Beide Stufen unterliegen definierten Kontrollen. Jeder Agent ist einzeln aktivierbar und auf bestimmte Systeme, Monitoring-Pakete oder Bereiche begrenzbar. Rollen, Berechtigungen und Freigabestufen bestimmen, ob Aktionen vorbereitet, nach Bestätigung ausgeführt oder innerhalb vorab genehmigter Leitplanken selbstständig durchgeführt werden. Eingriffe, Entscheidungen, Begründungen und Ergebnisse bleiben transparent dokumentiert. Die menschliche Verantwortung bleibt gewahrt.
Outcome
Struktureller Mehrwert für Unternehmen
Adaptive Monitoring ermöglicht Unternehmen:
einheitliche Überwachungsmodelle und eine schnellere Integration neuer Anwendungen, Ressourcen und Dienste
weniger manuelle Konfigurations- und Betriebsaufwände
weniger Alarmrauschen und eine höhere Relevanz der verbleibenden Ereignisse
klare Verantwortlichkeiten, nachvollziehbare Prozesse und kontrollierten Self-Service
die Integration bestehender Monitoring- und Observability-Systeme
den schrittweisen Ausbau um Automatisierungs- und AI-Fähigkeiten
Monitoring entwickelt sich so von einer Sammlung einzelner Regeln zu einem transparenten, einheitlich steuerbaren und kontinuierlich weiterentwickelbaren Betriebsmodell.
Praxisbewährt
Das zugrunde liegende Betriebsmodell ist bei PlanB. seit 2015 produktiv im Einsatz und für komplexe Enterprise-Umgebungen skaliert. Wiederverwendbare Monitoring-Pakete, automatisierte Bereitstellung, kontrollierter Self-Service und die Trennung von Monitoring und Routing haben sich im operativen Betrieb bewährt. Die beschriebenen AI-Fähigkeiten erweitern dieses Fundament schrittweise.
Die produktive Größenordnung umfasst 25 Teams beziehungsweise Kundenumgebungen. In einem angebundenen Monitoring-System werden rund 4.000 IT-Objekte und mehr als 100.000 zugehörige technische Komponenten überwacht. Im Oktober 2025 steuerten 28 wiederverwendbare Monitoring-Pakete insgesamt 3.500 Routings für offene und geschlossene Alerts.
Im produktiven Einsatz wurden folgende Effekte erzielt:
bis zu 75 % weniger Aufwand für die Provisionierung
bis zu 90 % kürzere Provisionierungszeiten
bis zu 60 % weniger Betriebsaufwand
Kontakt
Möchten Sie dieses Thema vertiefen oder eine konkrete Fragestellung besprechen? In einem kurzen Gespräch gehen wir auf Ihre Anliegen ein, klären den Kontext und schlagen praktische nächste Schritte vor – ganz unverbindlich.